


技术分享︱SIMFORGE HSF® 网格加密与热点加速技术实践
引言
工程仿真规模持续增大后,网格和计算往往同时成为瓶颈。关键区域需要更高分辨率,网格变化后拓扑、边界和场数据仍要保持完整,长时间迭代中的高频循环还要充分利用并行硬件。SIMFORGE HSF® 围绕这条计算链路,逐步形成了 SAMR、USTR 两类网格加密能力,并将 GPU 热点计算接入统一的求解流程。
本文将按两部分展开:第一部分介绍网格加密,分别对应 SAMR 的分层自适应和 USTR 的非结构网格细分;第二部分介绍热点加速,从 GPU 计算路径、算子优化到工程算例验证,展示这些能力如何在同一框架中衔接。
Part1 网格加密
/ 围绕“哪里需要更细”和“加密后信息是否完整”展开
01 HSF-SAMR:面向复杂几何与流场演化的自适应加密
SAMR 采用 Octree 管理空间层级,每个叶节点关联规则 Block。Octree 负责网格层级与空间拓扑,Block 负责局部数据存储和高效遍历。这样的组织方式可以在全局保持灵活的加密层次,同时利用规则块内连续、规整的数据访问。
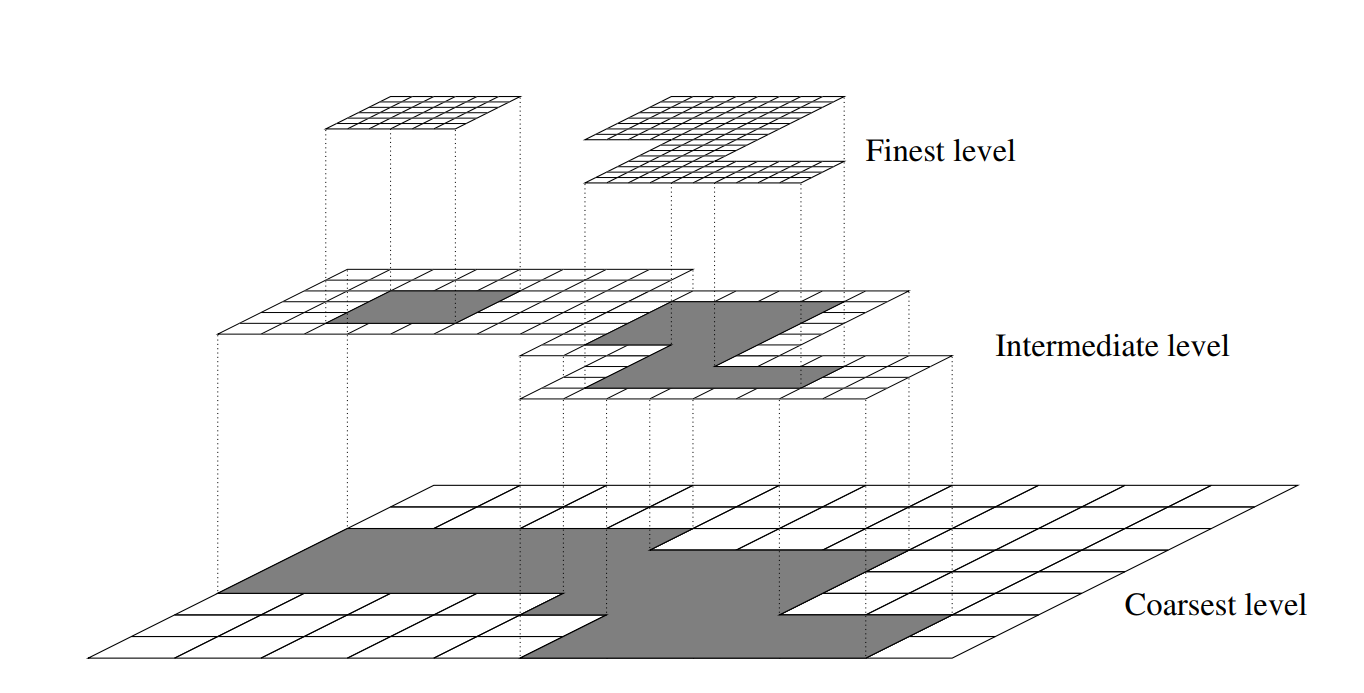
图1 SAMR 多层分块网格示意:不同区域可处于不同分辨率层级
1.1 几何自适应与指定区域加密
复杂外形进入计算域后,框架可根据 STL 表面与网格的空间关系,在几何边界附近自动提高分辨率。对于尾迹区、局部观测区等已知重点区域,也可以直接用 Box 描述加密范围,将网格细化到指定层级。
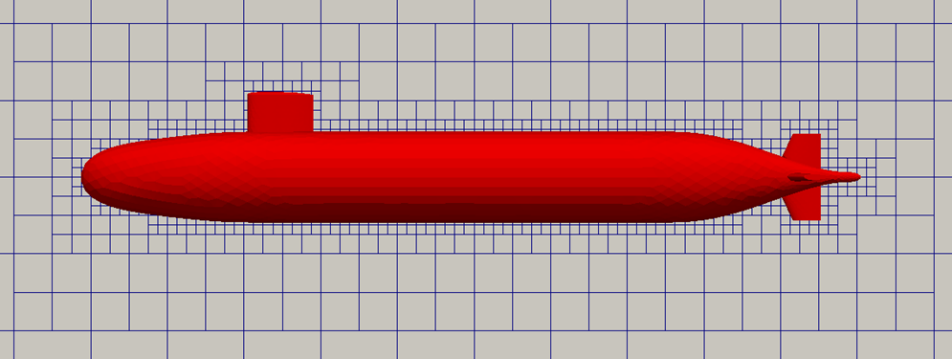
图2 几何自适应:复杂外形附近自动形成更细的网格层级
指定区域加密和几何加密可以叠加使用。应用层只需要给出区域与层级,底层完成 Octree 调整、Block 重建和后续数据准备,求解器仍通过统一的数据容器访问场变量。
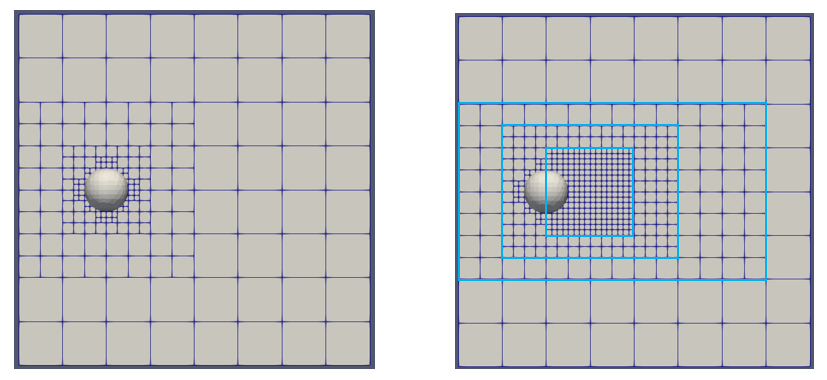
图3 指定区域加密:通过空间范围控制局部分辨率
1.2 体素化:让几何边界进入网格体系
网格生成之后,还需要确定计算单元与几何模型之间的关系。SAMR 采用两级体素化:先以 Block 为单位快速区分 inside、outside 和 cross,再对相交 Block 内的 Cell 做精细判断,得到边界单元及切割信息。这样可以把高成本几何判断限制在边界附近。
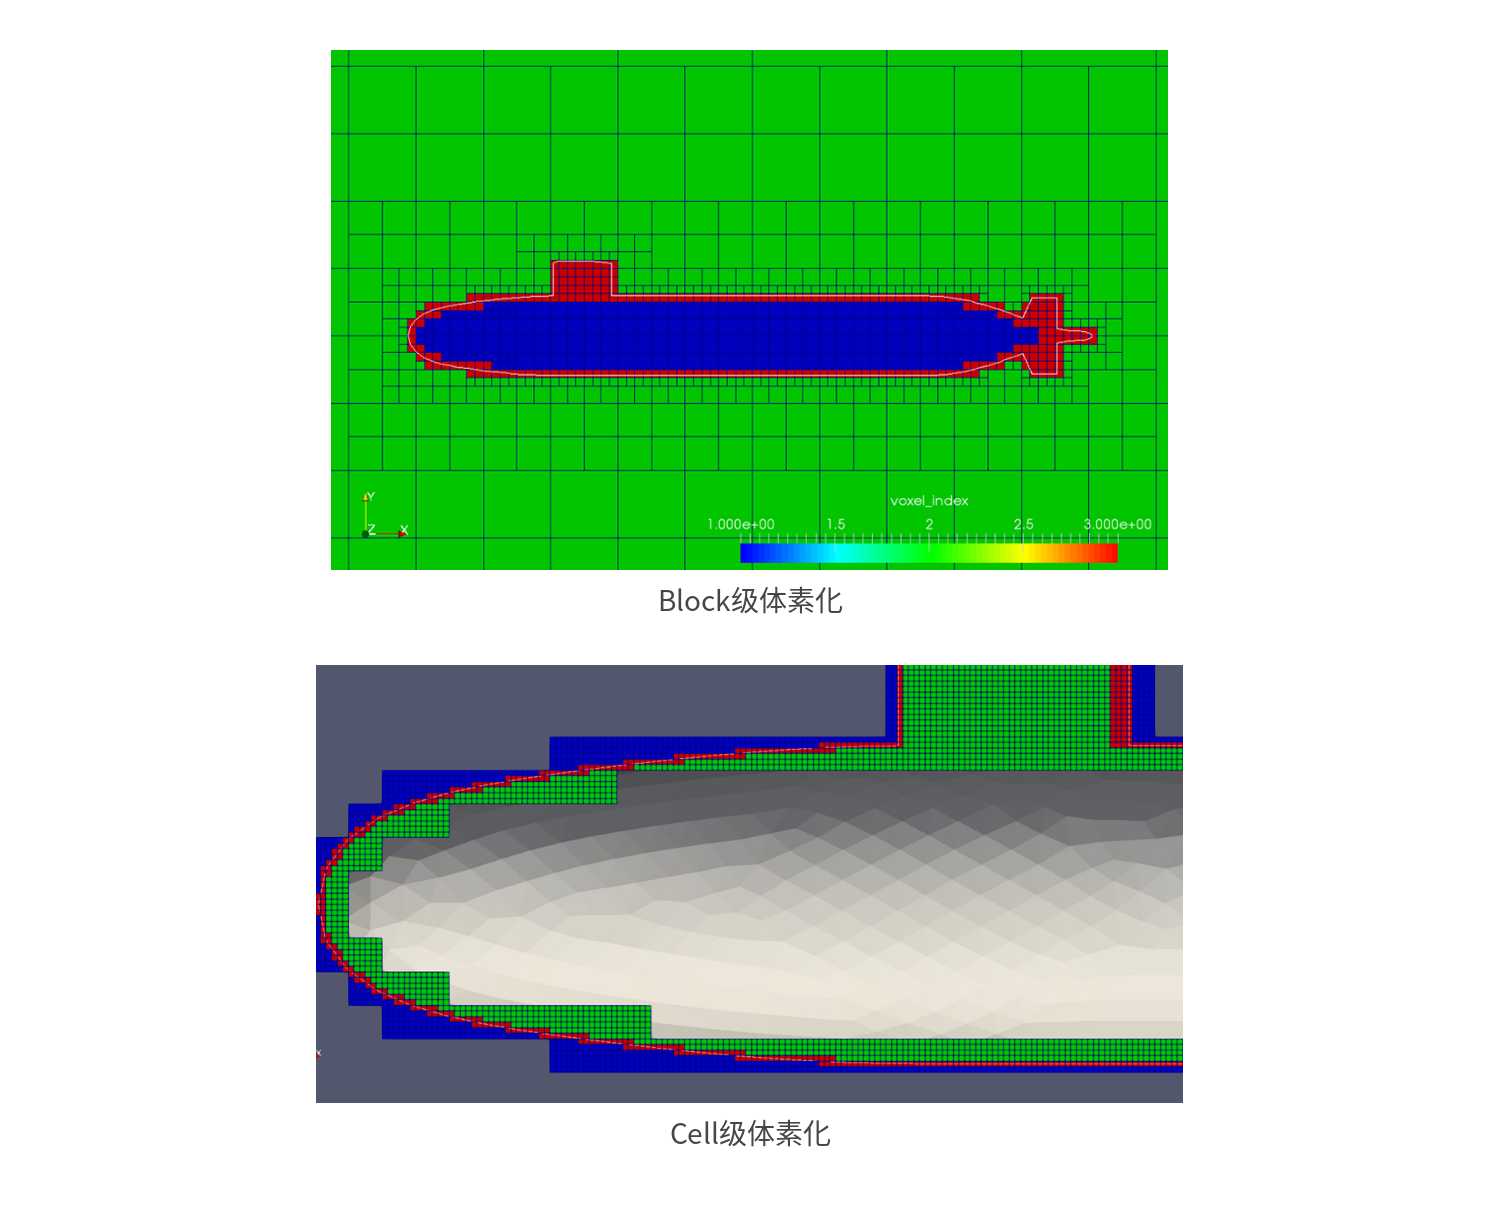
图4 两级体素化:先定位相交 Block,再细化到 Cell 级边界判断
体素化结果直接服务于浸入边界、切割单元和边界条件处理。远离几何表面的规则区域仍保持连续 Block 计算,边界附近则保留更细的几何描述。
1.3 解自适应与场数据迁移
流场特征会随时间演化,固定加密区很难覆盖所有关键结构。SAMR 可以从速度梯度、涡量等场量提取加密依据,生成 refine、coarsen 和 unchange 标记,再完成 Octree 拓扑调整。细网格随特征区域移动,计算量也随之重新分布。
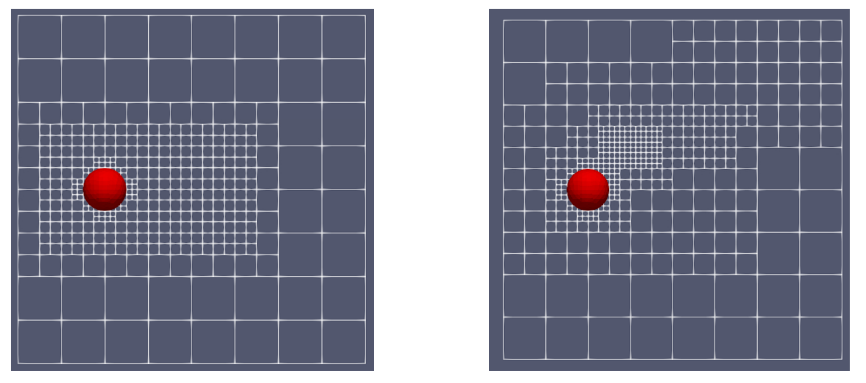
图5 解自适应示意:细网格随局部特征区域重新分布
网格层级变化后,场数据还要同步细化或粗化。框架在网格更新过程中完成插值、平均和数据迁移,并配合逐层负载调整,使新的网格拓扑可以直接进入下一阶段计算。
02 HSF-USTR:面向非结构网格的多单元细分与集合继承
USTR 面向非结构网格,加密时需要同时处理单元形状、点线面体拓扑、跨进程编号和算例集合。当前加密能力已覆盖工程算例中使用的主要三维单元类型。不同单元采用各自的细分模板,上层统一使用父子关系、拓扑重建和集合更新流程。
2.1 从单元细分到完整网格重建
以六面体为例,一个母单元通过边中点、面心和体心等新增节点完成规则细分,形成 8 个子单元。多层加密由一次参数设置触发,框架连续完成节点生成、子单元构建和父子关系记录,最后统一更新所需的拓扑与相关变量。
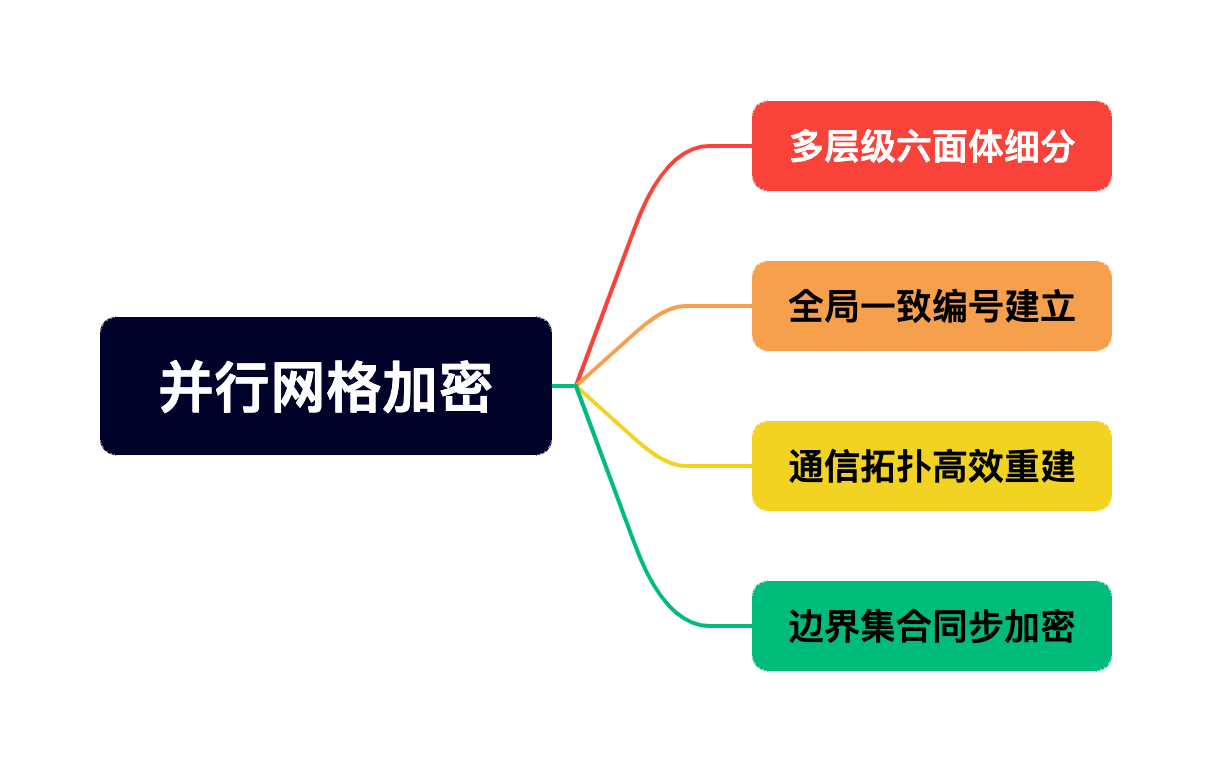
图6 USTR 并行网格加密需要同时处理单元细分、编号、拓扑和边界集合
这套流程的重点在于把几何细分和网格语义放在同一个阶段处理。加密层数提高后,Cell2Node、节点坐标、单元属性、单元类型、局部到全局编号等信息都要同步更新,避免后续模块再做二次修补。
2.2 分布式新增节点与全局编号
并行环境中,同一个进程边界上的新增节点可能由多个进程同时看到。USTR 复用原有 Shared Node / Edge / Face 关系识别加密后的共享实体,并使用确定性的层级关系对共享节点排序,避免浮点坐标排序带来的不确定性。随后依据 Owner 和全局 Offset 生成编号,再将 Owner 侧的全局 ID 同步给邻接进程。
原有进程边界信息在这里发挥了重要作用。它可以直接作为新 Shared 实体的查找入口,减少从零遍历和重建通信关系的成本,也使多层加密后的拓扑关系保持可追踪。
2.3 点、线、面、体集合跟着网格一起加密
工程算例中的材料区、载荷、约束和接触条件通常依赖 Subset。Cell、Face、Edge 集合可以根据父子实体关系直接映射到细分后的网格。Node Subset 更复杂:同一个点集合在物理上可能表示一条边、一个面,甚至一组单元。
表1 USTR 加密过程中需要同步维护的典型信息
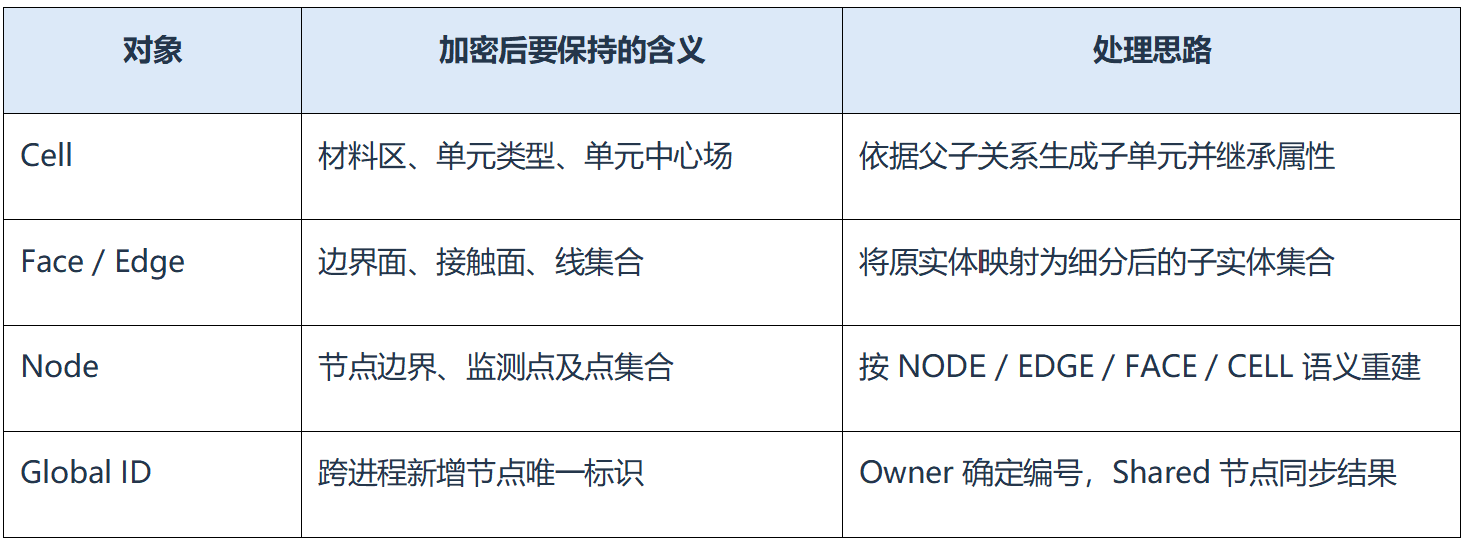
因此,USTR 为点集合提供 NODE、EDGE、FACE、CELL 四种重建语义。用户可以明确点集合对应的几何实体,框架先恢复原有边、面或体集合,再根据细分关系生成新的点集合。这样可以保持边界范围和物理作用区域不随加密发生偏移。
USTRMesh
uMesh(comm);uMesh.setRefineLevel(refineLevel);
uMesh.setNodeSubsetRebuildMethod(HSF::SetType::FACE);
2.4 加密结果进入完整验证链路
加密完成后,验证首先检查跨进程全局编号。各进程输出新增节点的全局 ID 与坐标并汇总,确认不存在“同一全局 ID 对应不同坐标”的冲突。随后通过可视化对照加密前后的边界集合,确认点、线、面、体集合仍位于正确位置。
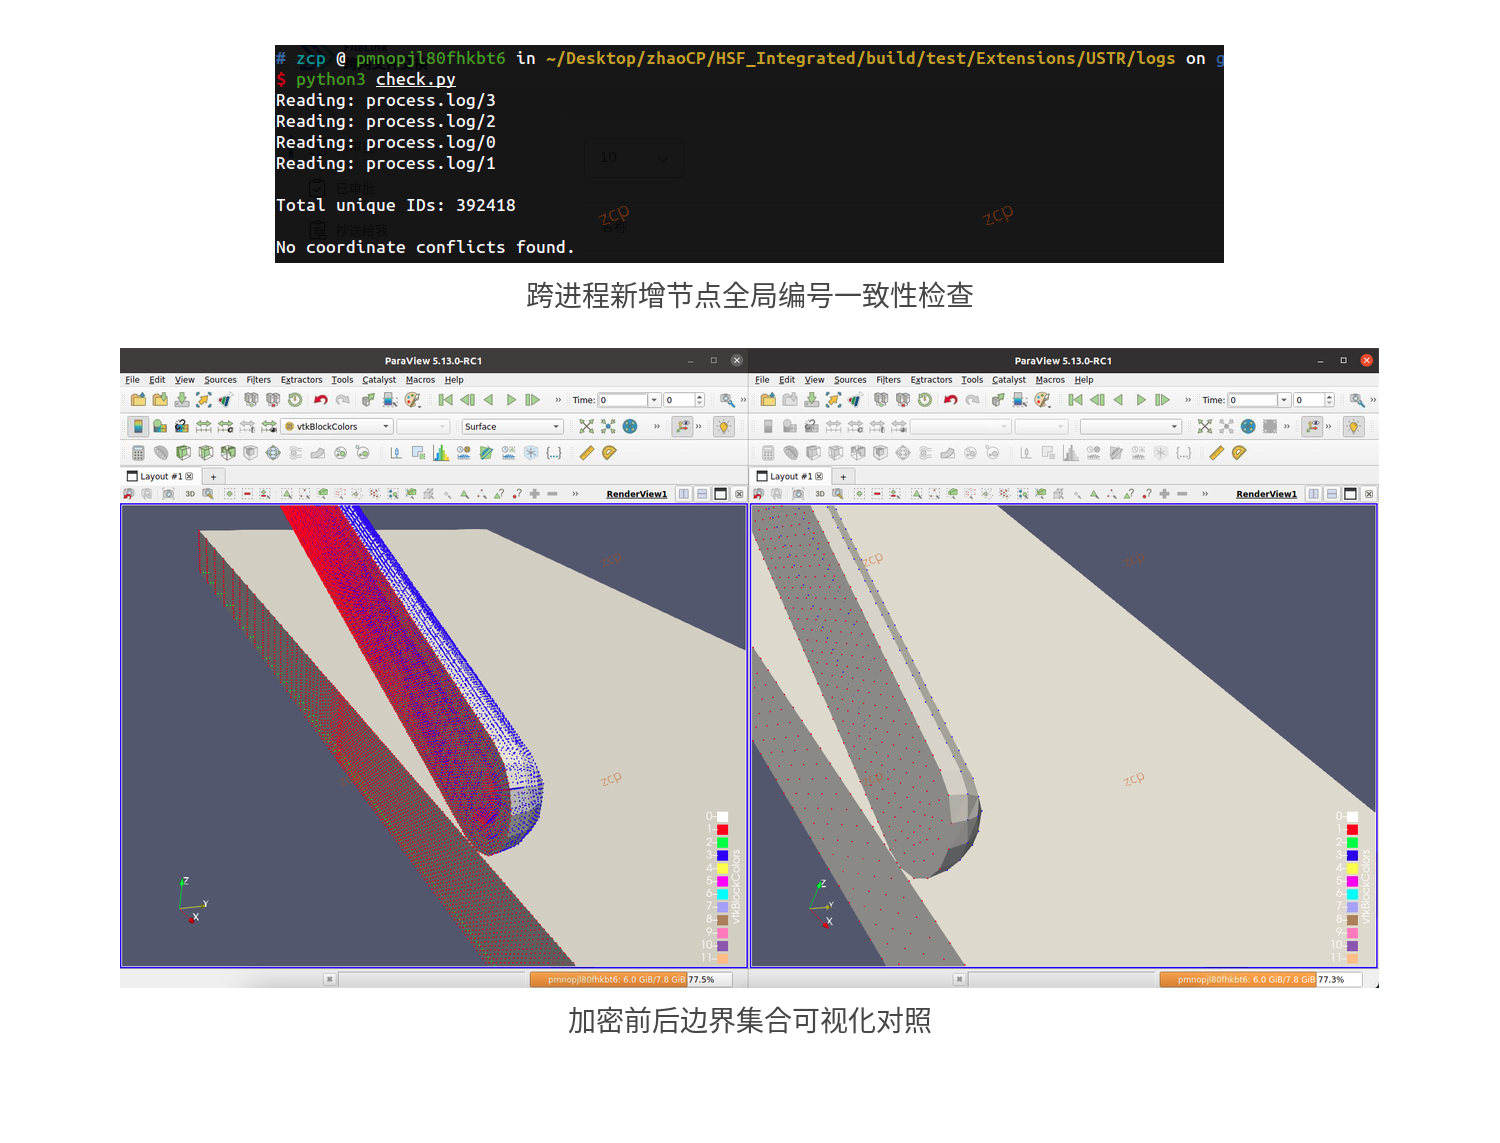
图7 USTR 加密验证:全局编号一致性与边界集合继承同时检查
这类验证直接对应求解阶段的使用需求。边界集合一旦缺失或错位,接触搜索、载荷施加和材料区域识别都会受到影响;把编号一致性和集合继承放进网格加密的基础测试,可以在求解器运行之前发现问题。
Part2 热点加速
/围绕“计算如何放到GPU上”和“端到端性能如何提升”展开
03 热点计算路径:保持求解流程稳定,把高频算子下沉到 GPU
长时间迭代中,高频算子会逐渐占据主要计算时间。以 LBM 为例,碰撞和迁移都具有规则、重复和高并行度的特点,适合交给 GPU 执行。HSF 保留原有迭代器组织方式,由 CPU 负责流程控制和必要的数据准备,设备相关实现集中在热点算子层。
进入热点计算前,迭代器取得 Block 和场数据的连续指针,统一调度入口再将计算提交到 GPU Kernel。上层求解器仍沿用原有流程,不需要维护两套相互独立的计算逻辑。
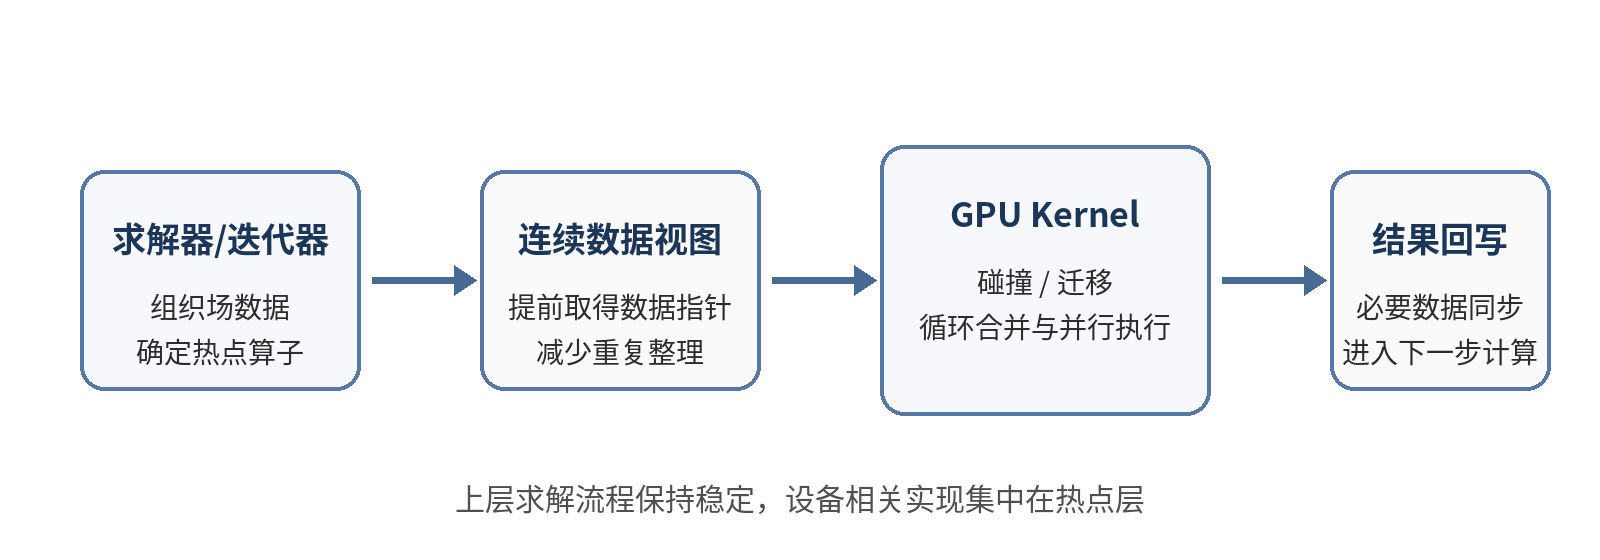
图8 GPU 热点计算路径:数据组织与设备端算子分层处理
04 GPU 算子优化:扩大并行粒度,减少数据搬运
4.1 合并循环,增加单次 Kernel 的有效工作量
热点代码首先处理并行粒度。原程序通常按 Block 遍历,再进入 ijk 多层循环;GPU 路径将外层 Block 与内部网格索引映射到统一线程空间,让更多网格点在同一次 Kernel 中并行执行。迁移过程中的多个小循环也尽量归并到共同的数据访问模式,减少频繁启动 Kernel 和重复索引计算。
4.2 数据传输逐渐成为端到端瓶颈
当 Kernel 计算速度明显提高后,Host 与 Device 之间的数据往返会在总耗时中占据更大比例。一次热点计算的时间拆分可以直观看到这一变化:纯计算已经压缩到很小的时间片,而数据拷贝仍然需要承担固定成本。
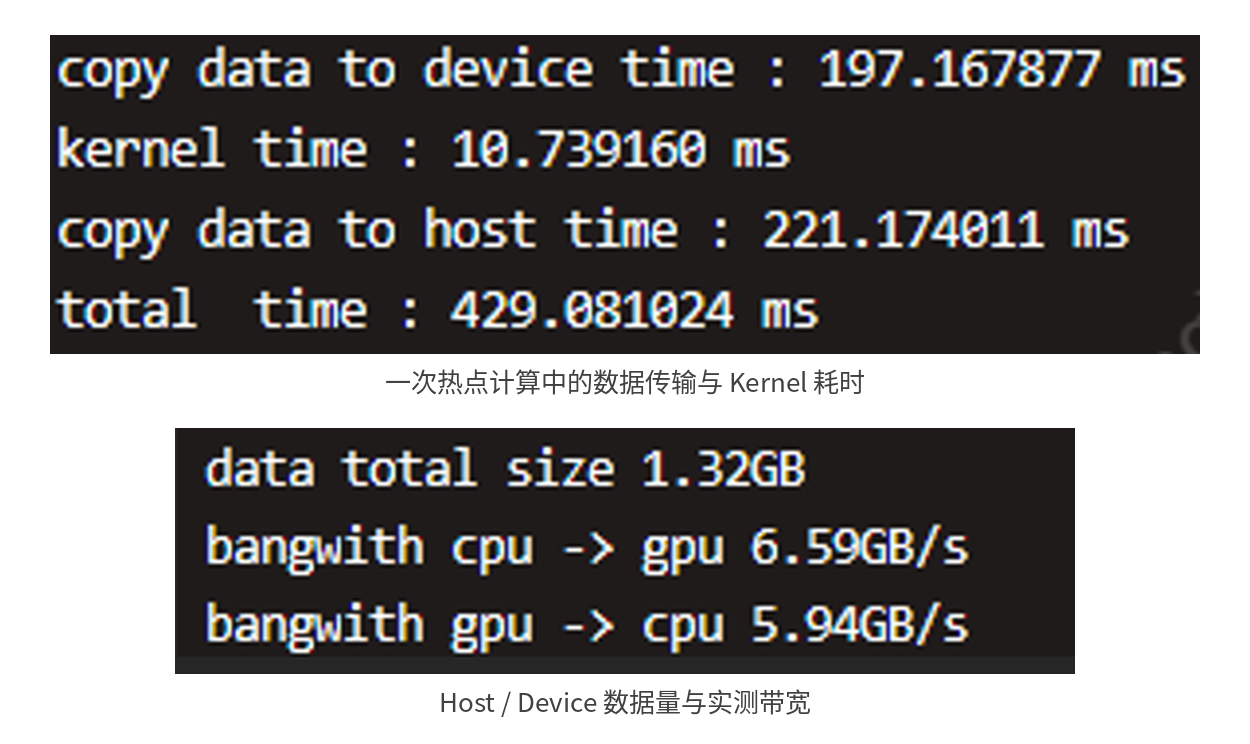
图9 GPU 热点中的数据传输与带宽:Kernel 加速后,数据搬运成为主要优化空间
后续优化的方向也随之明确:尽量延长关键场数据在 GPU 上的驻留时间,让连续热点算子复用同一份设备数据,只在确有需要时回写 CPU;同时减少中间格式转换和临时缓冲区重建,把端到端收益从单个 Kernel 扩展到完整时间步。
05 GPU热点加速验证:数值一致性与端到端加速效果
5.1 小球绕流:先确认 CPU / GPU 结果一致
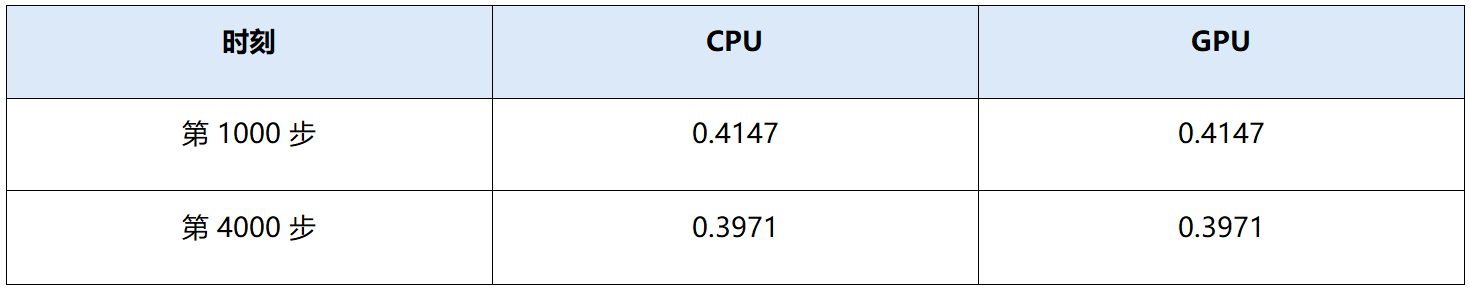
热点迁移完成后,首先通过经典小球绕流算例检查数值一致性。算例采用多层网格加密,细网格集中在球体近场和尾迹区域。CPU 与 GPU 计算得到的阻力系数保持一致,速度场分布也相互吻合。
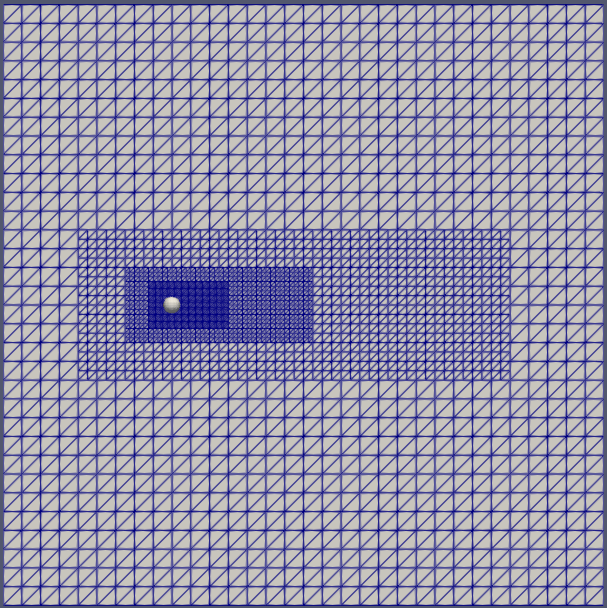
图10 小球绕流的多层网格布置
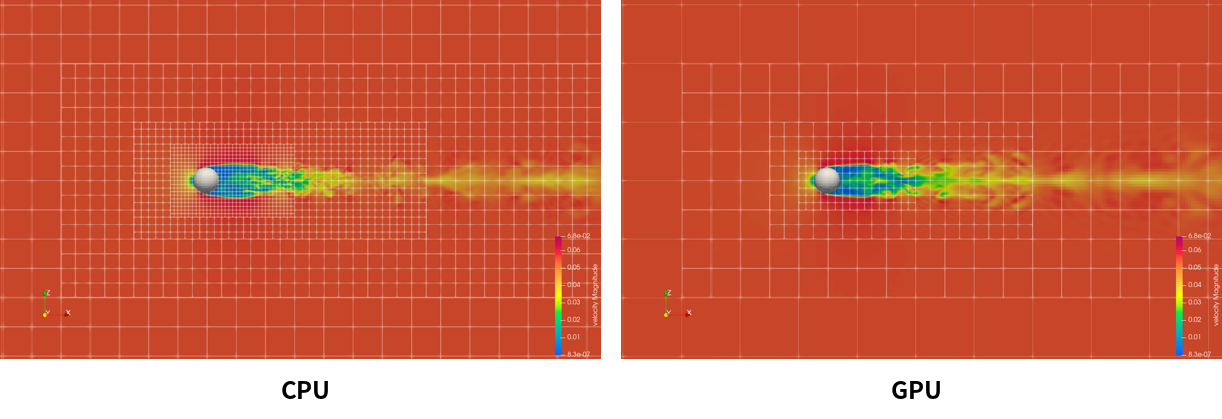
图11 同一时刻的速度场对比:CPU 与 GPU 结果保持一致
表2 小球绕流阻力系数对比
5.2 热点性能:Kernel 收益已经比较明显
在相同算例规模下,迁移热点的 GPU 纯计算加速约 77 倍,包含数据传输后的端到端加速约 4.6 倍;碰撞热点的纯计算加速约 190 倍,端到端加速同样约 4.6 倍。两组结果说明 GPU 侧计算能力已经得到发挥,总体性能进一步提升主要取决于数据驻留和传输策略。
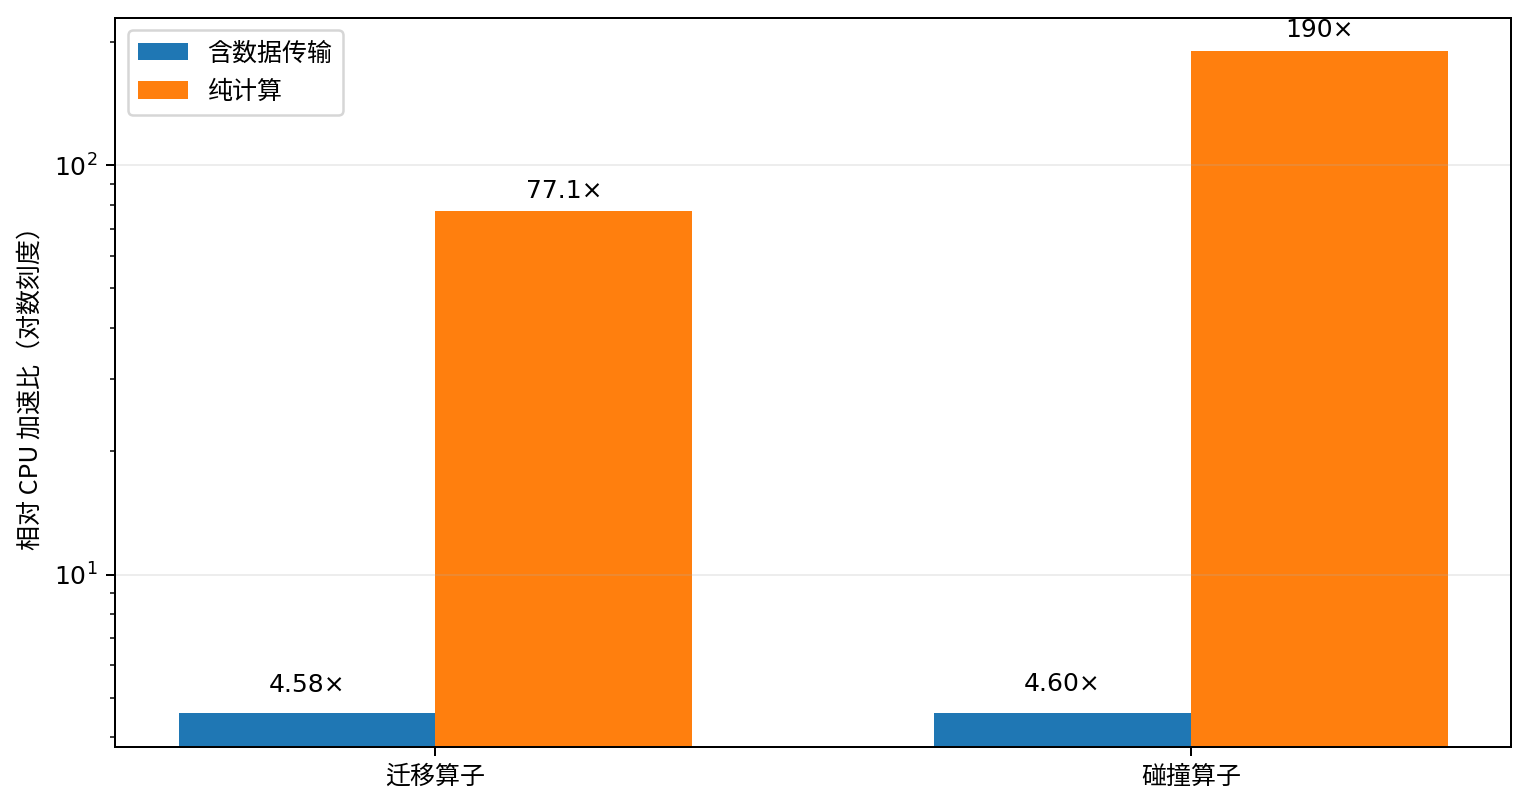
图12 迁移与碰撞热点的 GPU 加速效果
5.3 大规模外流场:网格能力与热点加速协同工作
在更大规模的外流场算例中,SAMR 通过多层网格把分辨率集中在艇体近壁面和尾迹区域,求解器在此基础上执行长时间迭代。速度场与压力场能够连续呈现尾迹结构,也说明网格组织、场数据和热点计算可以在同一计算链路中稳定衔接。
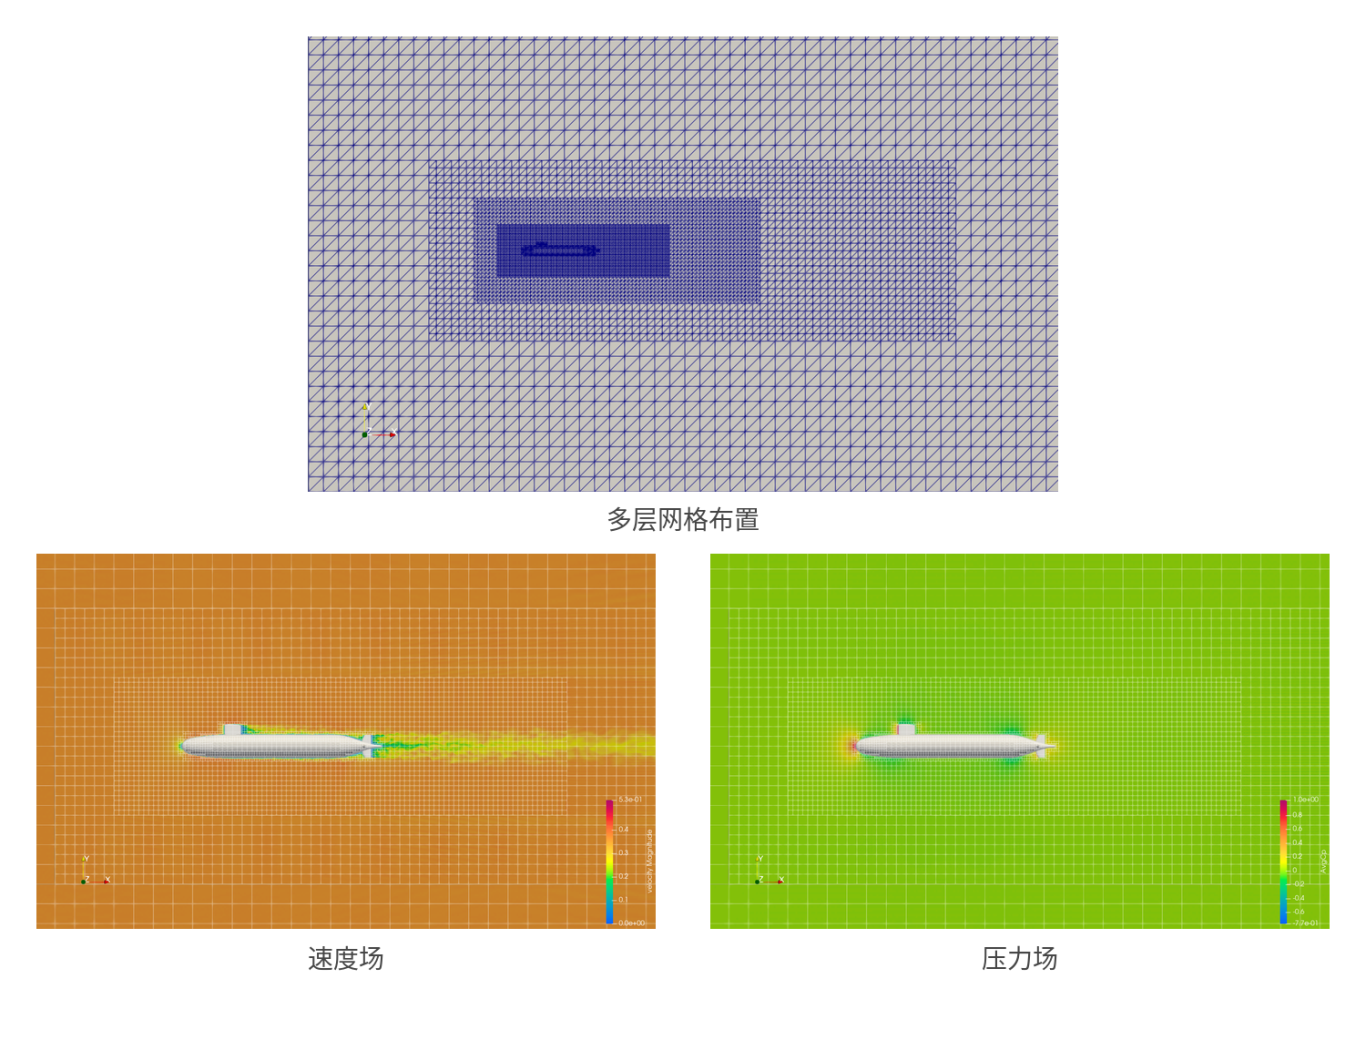
图13 大规模外流场算例:多层网格、速度场与压力场结果
06 结语
从网格加密到 GPU 热点优化,SIMFORGE HSF® 目前已经形成两条比较清晰的技术链路。SAMR 负责复杂几何和演化流场中的局部分辨率,USTR 负责非结构网格细分后的拓扑与集合继承;进入求解阶段后,迭代器继续组织数据,把高频算子交给 GPU 执行。
这套能力的价值体现在应用层:网格可以围绕关键区域持续细化,加密后边界与材料信息能够直接沿用,求解器也无需因为硬件路径变化大幅重写。
神工坊®团队将持续深耕 SIMFORGE HSF® 超智融合数值引擎的研发,继续围绕复杂单元、集合条件、网格更新过程中的数据复用,以及 GPU 数据驻留与多算子融合等方向展开攻关。


技术专长


评论0